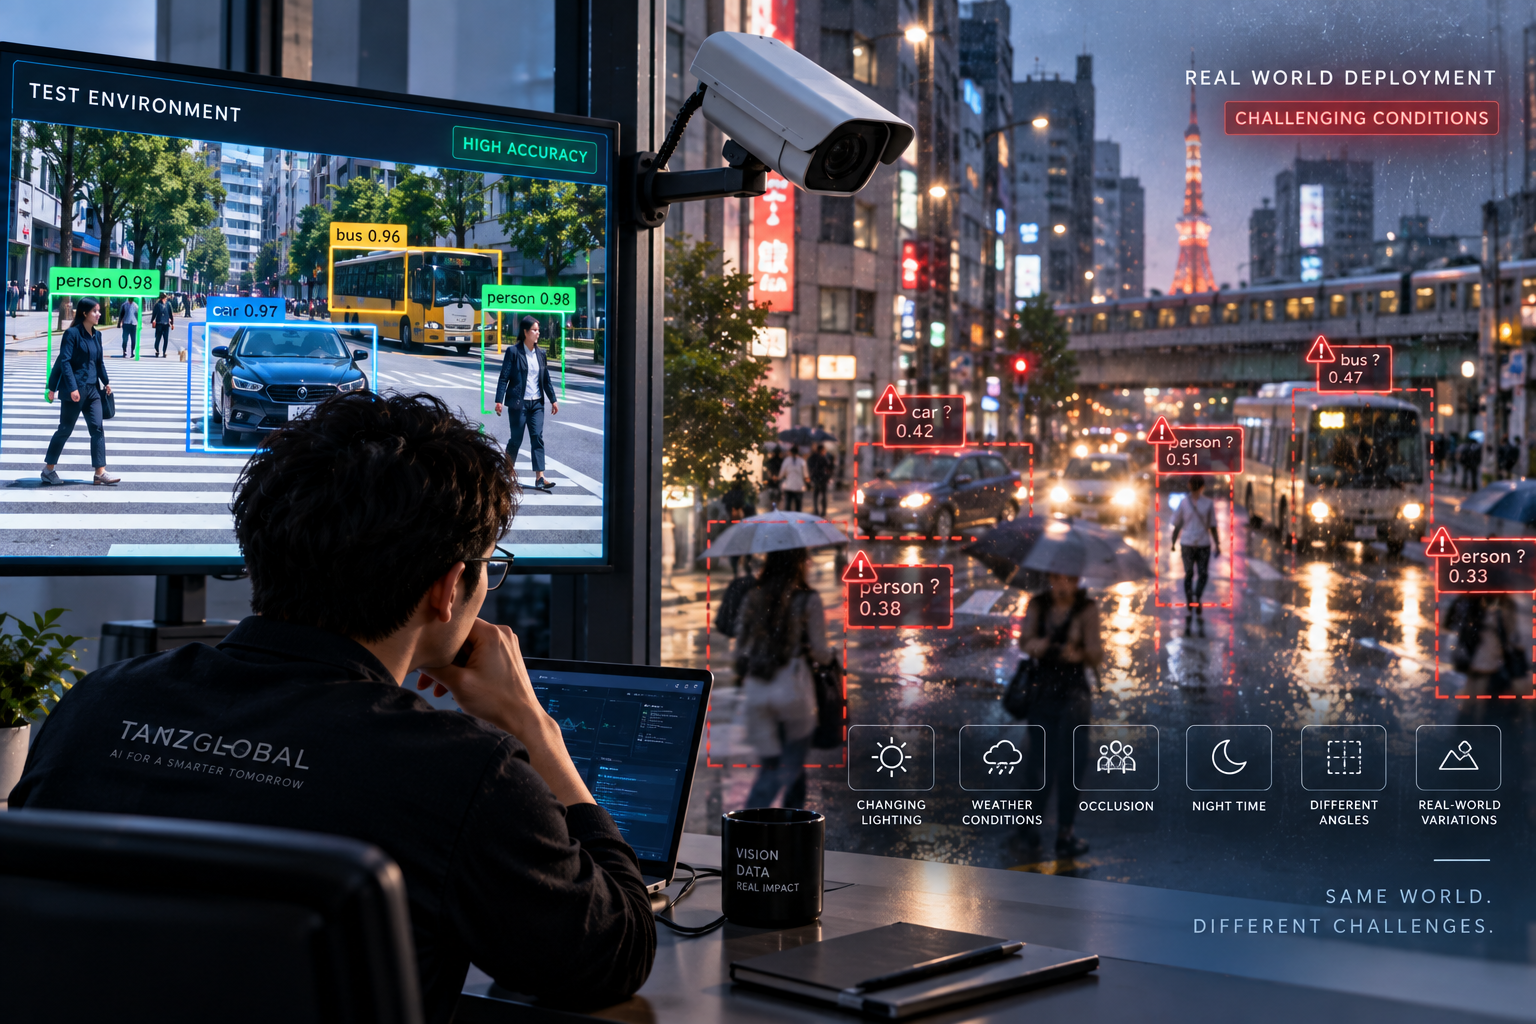
Sebuah sistem computer vision sudah selesai dikembangkan. Saat diuji menggunakan kumpulan gambar, hasilnya terlihat meyakinkan. Mobil terdeteksi sebagai mobil, manusia dapat dibedakan dari objek lain, dan tingkat akurasinya bahkan mencapai angka yang terlihat sangat tinggi.
Kemudian sistem dipasang pada kamera sungguhan.
Tiba-tiba objek yang sebelumnya mudah dikenali mulai terlewat. Orang yang berdiri di bawah bayangan tidak terdeteksi, kendaraan pada malam hari menghasilkan prediksi aneh, dan kamera yang sedikit berubah sudut membuat performanya turun. Model yang terlihat pintar di laboratorium seolah menjadi jauh lebih tidak konsisten setelah bertemu dunia nyata.
Masalah seperti ini menunjukkan mengapa akurasi computer vision di dunia nyata tidak dapat dinilai hanya dari satu angka pengujian. Kualitas data, pencahayaan, posisi kamera, resolusi, kondisi lingkungan, hingga perbedaan antara data training dan situasi sebenarnya dapat menentukan apakah sebuah sistem AI benar-benar siap digunakan.
Akurasi 95 Persen Belum Menjelaskan Seluruh Kemampuan Model
Angka akurasi mudah dipahami.
Jika sebuah model memiliki accuracy 95 persen, kesan pertama adalah sistem tersebut benar dalam hampir seluruh situasi.
Namun pertanyaan pentingnya adalah: 95 persen dari data seperti apa?
Jika dataset pengujian sangat mirip dengan data training, model mungkin terlihat sangat bagus. Masalah baru muncul ketika kamera mendapatkan kondisi yang jarang atau bahkan tidak pernah muncul selama proses pelatihan.
Karena itu, angka performa harus selalu dibaca bersama karakteristik data yang digunakan untuk mengukurnya.
Model Belajar dari Contoh yang Diberikan
Computer vision tidak memahami dunia dengan cara yang sama seperti manusia.
Model mempelajari pola dari data.
Jika selama training sebagian besar foto mobil diambil pada siang hari, model mendapatkan banyak kesempatan mempelajari pola kendaraan dalam pencahayaan terang.
Tetapi bagaimana dengan mobil pada malam hari?
Bagaimana dengan hujan deras?
Bagaimana dengan kendaraan yang sebagian tertutup?
Jika contoh seperti itu sangat sedikit, performa pada kondisi tersebut dapat lebih lemah.
Dunia Nyata Jauh Lebih Berantakan daripada Dataset
Dataset biasanya memiliki struktur.
Gambar dikumpulkan.
Label diperiksa.
Ukuran disesuaikan.
Data yang rusak dapat dibuang.
Kondisi dunia nyata tidak selalu serapi itu.
Lensa kamera bisa kotor. Cahaya matahari masuk langsung ke sensor. Objek bergerak cepat. Hujan menutupi sebagian pandangan. Kamera bergetar. Orang berdiri saling menutupi.
Semua variasi tersebut menciptakan input yang lebih sulit dibandingkan contoh ideal.
Distribution Shift Menjadi Salah Satu Tantangan Besar
Dalam machine learning terdapat konsep yang sangat penting: distribution shift.
Secara sederhana, kondisi data yang diterima sistem setelah deployment berbeda dari data yang digunakan ketika model dikembangkan.
Misalnya sistem dilatih menggunakan gambar dari kamera indoor.
Kemudian teknologi yang sama dipasang di area semi-outdoor.
Objek yang dicari mungkin tetap sama, tetapi lingkungan visualnya berubah.
Background berbeda.
Pencahayaan berbeda.
Sudut kamera berbeda.
Model sekarang bekerja pada distribusi data yang tidak sepenuhnya dikenalnya.
Kamera yang Berbeda Bisa Menghasilkan Data yang Berbeda
Dua kamera sama-sama menghasilkan gambar.
Namun hasilnya belum tentu identik.
Sensor dapat berbeda.
Resolusi berbeda.
Dynamic range berbeda.
Lensanya berbeda.
Image processing internal juga dapat berbeda.
Jika model dikembangkan menggunakan satu jenis kamera lalu diterapkan pada perangkat yang karakteristik gambarnya jauh berbeda, performa perlu diuji kembali.
Resolusi Tinggi Tidak Otomatis Menyelesaikan Masalah
Kamera 4K terdengar seperti solusi sederhana.
Lebih banyak pixel berarti lebih banyak detail.
Namun sistem computer vision biasanya tidak memproses seluruh gambar dalam resolusi asli tanpa batas.
Input dapat di-resize sebelum masuk ke model.
Selain itu, resolusi tinggi meningkatkan kebutuhan bandwidth, storage, dan komputasi.
Pertanyaan yang lebih penting adalah apakah objek target memiliki cukup detail pada ukuran input yang benar-benar diproses model.
Ukuran Objek dalam Frame Sangat Penting
Bayangkan kamera mengawasi area parkir yang luas.
Sebuah mobil dekat kamera terlihat besar dan jelas.
Mobil di ujung area hanya menempati sedikit pixel.
Bagi manusia, keduanya tetap jelas sebagai kendaraan karena kita memiliki pemahaman konteks yang sangat kuat.
Bagi model, objek kecil bisa jauh lebih sulit.
Semakin sedikit informasi visual yang tersedia, semakin sulit membedakan detail yang diperlukan untuk klasifikasi atau deteksi.
Kamera Terlalu Tinggi Bisa Mengubah Bentuk yang Dilihat AI
Sudut pemasangan kamera bukan hanya persoalan cakupan.
Ia juga menentukan bagaimana objek terlihat.
Manusia yang dilihat dari depan memiliki bentuk visual berbeda dari manusia yang dilihat hampir vertikal dari atas.
Kendaraan dari samping berbeda dengan kendaraan dari sudut tinggi.
Jika dataset training didominasi satu perspektif sementara deployment menggunakan perspektif lain, performa dapat berubah.
Karena itu, desain sistem seharusnya mempertimbangkan kamera dan model secara bersamaan.
Posisi Kamera yang Bagus untuk Manusia Belum Tentu Bagus untuk AI
Operator CCTV mungkin menyukai satu kamera karena dapat melihat area sangat luas.
Namun computer vision bisa membutuhkan objek yang lebih besar dan sudut yang lebih konsisten.
Wide-angle berlebihan juga dapat menghasilkan distorsi.
Objek di tepi frame dapat terlihat berbeda dibandingkan objek di tengah.
Dalam beberapa kasus, dua kamera dengan cakupan lebih terarah bisa memberikan data yang lebih berguna daripada satu kamera yang mencoba melihat semuanya.
Cahaya Matahari Bisa Menjadi Masalah Serius
Pencahayaan outdoor berubah sepanjang hari.
Pagi.
Siang.
Sore.
Mendung.
Terik.
Semua menghasilkan karakter gambar berbeda.
Pada jam tertentu, matahari dapat berada tepat di belakang objek sehingga muncul backlight kuat.
Objek berubah menjadi lebih gelap sementara background sangat terang.
Jika sistem jarang melihat kondisi seperti ini saat training, tingkat deteksinya dapat menurun.
Bayangan Bisa Mengubah Tampilan Objek
Bayangan tampak sederhana bagi manusia.
Kita secara intuitif memahami bahwa bagian gelap di lantai bukan bagian dari tubuh seseorang.
Model harus mempelajari pola tersebut dari data.
Bayangan panjang, kontras tinggi, atau pencahayaan tidak merata dapat mengubah bentuk visual yang diterima sistem.
Inilah salah satu alasan dataset outdoor perlu mencakup variasi waktu dan cuaca.
Malam Hari Adalah Dunia Visual yang Berbeda
Sistem yang bagus pada siang hari belum tentu bagus pada malam hari.
Noise sensor meningkat.
Detail berkurang.
Lampu kendaraan menciptakan highlight.
Area tertentu sangat terang sementara bagian lain hampir hitam.
Jika kamera menggunakan infrared, karakter gambarnya berubah lagi.
Karena itu, pengujian malam tidak boleh dianggap sebagai versi lebih gelap dari pengujian siang.
Ia dapat menjadi kondisi data yang benar-benar berbeda.
Hujan Menambah Gangguan pada Beberapa Lapisan
Saat hujan, bukan hanya objek yang menjadi sedikit lebih gelap.
Tetesan air dapat menempel pada lensa.
Permukaan jalan memantulkan cahaya.
Kontras berubah.
Orang menggunakan payung.
Pakaian berubah.
Kendaraan menghasilkan cipratan.
Artinya satu perubahan cuaca dapat sekaligus mengubah banyak fitur visual.
Model yang akan digunakan outdoor perlu diuji pada kondisi seperti ini.
Kabut Mengurangi Informasi Visual secara Bertahap
Kabut memberikan tantangan berbeda.
Objek tidak langsung menghilang.
Kontrasnya berkurang seiring jarak.
Warna juga menjadi lebih sulit dibedakan.
Akibatnya, sistem mungkin masih mengenali objek dekat kamera tetapi mulai kehilangan objek yang lebih jauh.
Ini menunjukkan mengapa performa sebaiknya tidak hanya diukur berdasarkan kategori objek, tetapi juga kondisi dan jaraknya.
Lensa Kotor Bisa Mengalahkan Model yang Sangat Canggih
Kadang masalah bukan AI.
Masalahnya adalah kamera.
Debu.
Air.
Minyak.
Serangga.
Embun.
Semua dapat mengurangi kualitas gambar.
Model yang sangat bagus tidak dapat menciptakan informasi yang memang tidak ditangkap sensor.
Karena itu, maintenance hardware merupakan bagian dari reliability sistem computer vision.
Occlusion Membuat Objek Hanya Terlihat Sebagian
Di dunia nyata, objek jarang berdiri sendiri dengan background bersih.
Orang berjalan di belakang orang lain.
Mobil tertutup kendaraan di depannya.
Barang berada di belakang rak.
Sebagian tubuh tertutup meja.
Kondisi ini disebut occlusion.
Model perlu mampu mengenali objek dari informasi parsial jika aplikasi memang membutuhkan kemampuan tersebut.
Kerumunan Membuat Deteksi Semakin Sulit
Deteksi satu orang di koridor kosong relatif sederhana.
Mendeteksi puluhan orang yang saling menutupi jauh lebih menantang.
Bounding box dapat saling bertumpuk.
Bagian tubuh sulit dipisahkan.
Tracking juga lebih sulit karena identitas visual berpindah dan tertutup.
Karena itu, klaim performa people detection sebaiknya diuji dalam density yang sesuai dengan lokasi sebenarnya.
Motion Blur Bisa Menghilangkan Detail Penting
Objek bergerak cepat dapat menghasilkan blur.
Masalah menjadi lebih besar jika pencahayaan rendah karena kamera mungkin menggunakan exposure lebih panjang.
Plat kendaraan, bentuk objek kecil, atau detail lain menjadi sulit dibaca.
Solusinya tidak selalu mengganti model.
Pengaturan kamera seperti shutter, pencahayaan, dan posisi pemasangan juga dapat memengaruhi kualitas input.
Frame Rate Menentukan Seberapa Banyak Momen yang Terekam
Video sebenarnya merupakan rangkaian frame.
Jika frame rate rendah sementara objek bergerak cepat, posisi objek dapat berubah jauh antara dua frame.
Untuk sekadar mendeteksi keberadaan mobil, kondisi tersebut mungkin masih cukup.
Untuk tracking pergerakan yang cepat, kebutuhan bisa berbeda.
Karena itu, spesifikasi kamera sebaiknya mengikuti jenis analisis yang dilakukan.
AI Tidak Melihat “Orang”, tetapi Pola Visual
Manusia memiliki pengetahuan luas mengenai dunia.
Kita tahu orang dapat memakai jas hujan.
Membawa kardus.
Membungkuk.
Duduk.
Menggunakan helm.
AI hanya memiliki generalisasi yang terbentuk dari contoh.
Jika variasi penampilan tertentu sangat jarang dalam training data, confidence dapat menurun.
Inilah mengapa keragaman data sangat penting.
Dataset Besar Belum Tentu Dataset yang Tepat
Satu juta gambar terdengar lebih baik daripada sepuluh ribu.
Namun jumlah bukan satu-satunya faktor.
Jika satu juta gambar tersebut semuanya berasal dari kondisi yang hampir sama, keragamannya tetap terbatas.
Sebaliknya, dataset lebih kecil yang secara sengaja mencakup variasi deployment dapat sangat berguna.
Pertanyaannya bukan hanya “berapa banyak data?”
Tetapi “apakah data tersebut mewakili kondisi yang akan dihadapi?”
Class Imbalance Dapat Membuat Model Terlihat Bagus
Bayangkan sistem harus mendeteksi dua kondisi.
Kondisi normal muncul 99 persen dari waktu.
Kondisi penting hanya 1 persen.
Model yang selalu menjawab “normal” secara teoritis bisa mendapatkan accuracy 99 persen.
Namun sistem tersebut sama sekali gagal pada tugas yang sebenarnya penting.
Contoh ini menunjukkan mengapa accuracy saja tidak selalu menjadi metrik terbaik.
Precision dan Recall Menjawab Pertanyaan Berbeda
Untuk sistem deteksi, dua metrik yang sering relevan adalah precision dan recall.
Precision berkaitan dengan seberapa banyak deteksi positif yang memang benar.
Recall berkaitan dengan seberapa banyak kejadian yang seharusnya ditemukan berhasil dideteksi.
Trade-off keduanya bergantung pada aplikasi.
Dalam beberapa sistem, false alarm sangat mengganggu.
Dalam sistem lain, kehilangan satu kejadian penting jauh lebih berbahaya.
False Positive Bukan Sekadar “AI Salah”
Misalnya sistem mendeteksi seseorang padahal sebenarnya hanya bayangan atau objek lain.
Itu false positive.
Jika terjadi sesekali, mungkin tidak menjadi masalah besar.
Namun jika sistem menghasilkan ratusan alarm palsu setiap hari, operator dapat mulai mengabaikan notifikasi.
Sekarang kesalahan model berubah menjadi masalah operasional manusia.
Karena itu, evaluasi harus mempertimbangkan dampak nyata, bukan hanya statistik.
False Negative Bisa Lebih Mahal
False negative terjadi ketika objek atau kejadian yang seharusnya terdeteksi justru terlewat.
Dalam quality inspection, produk cacat bisa lolos.
Dalam monitoring area, kejadian penting tidak tercatat.
Dalam traffic analytics, kendaraan tidak dihitung.
Nilai kesalahan tergantung pada use case.
Tidak semua error memiliki biaya yang sama.
Confidence Score Bukan Probabilitas Sederhana yang Selalu Sempurna
Model sering menghasilkan confidence score.
Pengguna mudah membacanya sebagai “AI 90 persen yakin.”
Interpretasi sebenarnya bisa lebih kompleks.
Confidence dipengaruhi model, data, dan kalibrasi.
Threshold kemudian menentukan kapan prediksi dianggap cukup kuat untuk digunakan.
Karena itu, threshold sebaiknya tidak dipilih secara sembarangan hanya karena angka tertentu terlihat aman.
Threshold Mengubah Perilaku Sistem
Turunkan threshold dan sistem mungkin mendeteksi lebih banyak objek.
Namun false positive juga bisa meningkat.
Naikkan threshold dan prediksi menjadi lebih selektif.
Tetapi beberapa objek nyata dapat terlewat.
Tidak ada threshold universal yang sempurna.
Nilai yang tepat harus mengikuti kebutuhan aplikasi dan risiko kesalahan.
Uji Model Berdasarkan Kondisi, Bukan Hanya Total
Misalnya overall detection rate terlihat bagus.
Coba pecah datanya.
Siang versus malam.
Cerah versus hujan.
Objek dekat versus jauh.
Kamera A versus kamera B.
Area sepi versus ramai.
Hasil agregat dapat menyembunyikan kelemahan besar pada satu kondisi tertentu.
Testing Harus Meniru Deployment
Jika sistem akan dipasang di gudang, lakukan pengujian dengan kondisi gudang.
Jika digunakan di jalan, gunakan video jalan nyata.
Jika kamera berada pada ketinggian enam meter, jangan hanya menguji footage dari kamera setinggi dua meter.
Semakin dekat testing dengan deployment, semakin berguna hasil evaluasinya.
Synthetic data dan dataset umum tetap berguna, tetapi tidak menggantikan validasi lapangan.
Pilot Deployment Bisa Menemukan Masalah yang Tidak Terlihat di Lab
Daripada langsung memasang sistem ke ratusan kamera, deployment kecil dapat memberikan banyak informasi.
Kamera dipasang pada beberapa lokasi representatif.
Model berjalan dalam kondisi nyata.
Error dikumpulkan.
Operator memberikan feedback.
Dari sana tim mengetahui apakah masalah utama berasal dari model, kamera, jaringan, atau workflow.
Pilot mengubah asumsi menjadi bukti.
Edge Cases Justru Sering Menentukan Kualitas Sistem
Model mungkin bekerja baik pada 95 persen kondisi normal.
Tetapi bagaimana dengan lima persen sisanya?
Orang membawa benda besar.
Kendaraan berhenti pada posisi tidak biasa.
Refleksi kaca.
Bayangan ekstrem.
Kamera terguncang.
Objek masuk frame hanya beberapa detik.
Edge case seperti ini sering menjadi sumber keluhan setelah deployment.
Jangan Hanya Mengumpulkan Contoh yang Berhasil
Setelah sistem berjalan, data paling berharga sering justru berasal dari kegagalan.
Frame ketika objek terlewat.
False alarm.
Kondisi cuaca tertentu.
Sudut yang membingungkan.
Kumpulan error tersebut dapat digunakan untuk memahami kelemahan model.
Dengan proses yang benar, deployment menjadi sumber data untuk meningkatkan generasi model berikutnya.
Active Learning Bisa Membantu Memilih Data yang Berguna
Tidak semua frame baru perlu dilabeli.
Jumlah video dapat sangat besar.
Active learning mencoba memprioritaskan contoh yang paling informatif, misalnya prediksi dengan uncertainty tinggi atau kondisi yang berbeda dari data sebelumnya.
Pendekatan seperti ini dapat membuat proses pengembangan dataset lebih efisien.
Tim fokus pada data yang kemungkinan memberikan peningkatan terbesar.
Retraining Bukan Berarti Model Lama Gagal Total
Lingkungan dapat berubah.
Layout toko berubah.
Jenis produk baru muncul.
Seragam pekerja berganti.
Kamera diganti.
Kondisi lalu lintas berkembang.
Model yang awalnya sesuai dapat perlahan menghadapi data berbeda.
Retraining merupakan bagian normal dari lifecycle machine learning ketika distribusi data berubah.
Model Drift Perlu Dipantau
Dalam sistem AI produksi, performa tidak seharusnya diasumsikan tetap selamanya.
Jika karakter input berubah, performa dapat menurun.
Monitoring membantu menemukan perubahan tersebut.
Misalnya rata-rata confidence turun pada kamera tertentu.
False alarm meningkat setelah renovasi.
Deteksi malam memburuk setelah pencahayaan diganti.
Sinyal seperti ini dapat menunjukkan bahwa sistem perlu dievaluasi kembali.
Perubahan Kecil pada Lingkungan Bisa Berdampak Besar
Bayangkan sistem digunakan untuk mendeteksi paket pada conveyor.
Kemudian perusahaan mengganti warna belt.
Bagi manusia, perubahan tersebut tampak tidak relevan.
Namun jika background baru memiliki karakter visual berbeda dari training data, performa bisa berubah.
Inilah alasan machine learning production membutuhkan change management.
Perubahan fisik perlu dipertimbangkan bersama sistem digital.
Tracking Menambahkan Lapisan Masalah Baru
Mendeteksi objek dalam satu frame berbeda dengan mengikuti objek sepanjang video.
Tracking harus menentukan apakah objek pada frame berikutnya masih merupakan objek yang sama.
Occlusion, crossing, perubahan arah, dan kerumunan dapat menyebabkan identity switch.
Karena itu, sistem dengan tracking perlu memiliki evaluasi tersendiri.
Akurasi detector saja belum cukup.
Kamera Bergerak Membuat Tracking Lebih Sulit
Banyak sistem menggunakan kamera tetap karena background relatif konsisten.
Jika kamera bergerak, seluruh scene berubah.
Gerakan background perlu dibedakan dari gerakan objek.
PTZ camera yang mengubah zoom atau arah juga menghasilkan kondisi visual baru.
Model dan tracking pipeline harus dirancang untuk skenario tersebut jika memang diperlukan.
Latency Sama Pentingnya dengan Accuracy untuk Aplikasi Real-Time
Model bisa sangat akurat tetapi membutuhkan lima detik untuk memproses satu frame.
Untuk analisis offline, mungkin masih berguna.
Untuk sistem real-time, mungkin terlalu lambat.
Latency menentukan seberapa cepat hasil tersedia setelah kejadian terjadi.
Karena itu, deployment AI selalu memiliki kompromi antara kualitas model dan kebutuhan komputasi.
Model Lebih Besar Tidak Selalu Lebih Baik
Model besar dapat memberikan akurasi lebih tinggi pada benchmark.
Namun membutuhkan GPU lebih kuat, listrik lebih besar, dan waktu inferensi lebih panjang.
Model yang sedikit lebih kecil tetapi cukup akurat dapat lebih cocok untuk deployment edge.
Kualitas sistem tidak ditentukan oleh ukuran neural network.
Ia ditentukan oleh seberapa baik seluruh solusi memenuhi kebutuhan.
Edge Computing Mengurangi Ketergantungan pada Cloud
Pada edge computer vision, sebagian pemrosesan dilakukan dekat dengan kamera.
Keuntungannya dapat mencakup latency lebih rendah dan berkurangnya kebutuhan mengirim video mentah terus-menerus.
Namun perangkat edge memiliki resource terbatas.
Model perlu dioptimalkan.
Thermal management juga penting.
Deployment hardware menjadi bagian dari desain AI.
Cloud Tetap Berguna untuk Banyak Skenario
Cloud menawarkan komputasi yang mudah diperluas dan pengelolaan terpusat.
Untuk analisis yang tidak membutuhkan respons sangat cepat, pendekatan ini dapat masuk akal.
Namun bandwidth, latency, biaya transfer, dan privasi perlu diperhitungkan.
Tidak ada jawaban bahwa semua computer vision harus edge atau semua harus cloud.
Arsitektur mengikuti kebutuhan.
Compression Bisa Mengubah Apa yang Dilihat Model
Video sering dikompresi untuk menghemat bandwidth dan storage.
Compression menghilangkan sebagian informasi visual.
Pada tingkat tertentu, manusia mungkin hampir tidak melihat perbedaannya.
Tetapi detail kecil yang dibutuhkan model dapat ikut hilang.
Artefak compression terutama dapat menjadi masalah untuk objek kecil atau analisis detail.
Karena itu, konfigurasi video perlu diuji bersama model.
Network Reliability Juga Memengaruhi Sistem
Jika video dikirim melalui jaringan, koneksi menjadi bagian dari pipeline.
Packet loss.
Bandwidth turun.
Delay.
Kamera offline.
Semua dapat menyebabkan data tidak tersedia.
Sistem AI tidak dapat mendeteksi objek pada frame yang tidak pernah diterima.
Karena itu, reliability computer vision harus mencakup infrastructure monitoring.
Jangan Menyalahkan Model Sebelum Mengecek Seluruh Pipeline
Ketika hasil salah, penyebabnya bisa berada di banyak tempat.
Kamera.
Encoder.
Network.
Preprocessing.
Model.
Post-processing.
Threshold.
Tracking.
Database.
Dashboard.
Jika troubleshooting hanya berfokus pada neural network, masalah sebenarnya bisa terlewat.
Pendekatan seperti yang dibahas di TanzGlobal perlu melihat computer vision sebagai sistem end-to-end, bukan sekadar model AI.
Human-in-the-Loop Masih Sangat Berguna
Tidak semua keputusan harus diberikan sepenuhnya kepada AI.
Untuk kasus tertentu, model dapat melakukan penyaringan awal.
Prediksi dengan confidence tinggi diproses otomatis.
Kasus ambigu dikirim kepada manusia.
Pendekatan ini dapat memberikan keseimbangan antara skala otomatisasi dan kontrol kualitas.
Terutama ketika biaya kesalahan tinggi.
AI Sebaiknya Membantu Operator, Bukan Membanjirinya
Bayangkan sistem menghasilkan 2.000 alert per shift.
Secara teknis, semuanya berhasil dikirim.
Secara operasional, sistem mungkin gagal.
Manusia memiliki kapasitas perhatian terbatas.
Alert perlu diprioritaskan, digabungkan, dan disajikan dengan konteks yang cukup.
Desain interface dan workflow akhirnya sama pentingnya dengan kemampuan deteksi.
Feedback Operator Bisa Menjadi Data Berharga
Operator adalah orang yang melihat kesalahan sistem setiap hari.
Jika mereka dapat menandai false alarm atau missed detection, feedback tersebut dapat membantu pengembangan.
Namun mekanismenya harus mudah.
Jika memberikan feedback membutuhkan terlalu banyak langkah, orang akan berhenti melakukannya.
Machine learning production membutuhkan hubungan antara teknologi dan pengguna.
Privasi Harus Dipikirkan Sejak Desain Awal
Computer vision dapat memproses informasi visual yang sensitif.
Karena itu, pertanyaan privasi sebaiknya muncul sebelum deployment.
Apakah video mentah benar-benar perlu disimpan?
Berapa lama?
Siapa yang dapat mengaksesnya?
Bisakah processing dilakukan secara lokal?
Apakah wajah perlu terlihat?
Prinsip data minimization dapat mengurangi risiko tanpa harus menghilangkan manfaat sistem.
Tidak Semua Aplikasi Membutuhkan Face Recognition
Mendeteksi bahwa ada manusia dalam sebuah area tidak sama dengan mengetahui siapa orang tersebut.
Untuk banyak aplikasi, identitas sama sekali tidak diperlukan.
People counting misalnya dapat dilakukan tanpa menyimpan identitas individu.
Memisahkan kebutuhan “mendeteksi keberadaan” dari “mengidentifikasi orang” membantu desain sistem menjadi lebih proporsional.
Model Bias Bisa Muncul dari Ketidakseimbangan Data
Jika dataset tidak merepresentasikan variasi kondisi deployment, performa dapat berbeda antar kelompok atau situasi.
Masalah ini bukan hanya soal jumlah data.
Distribusinya juga penting.
Audit dataset membantu mengetahui apa yang terlalu banyak, terlalu sedikit, atau bahkan tidak ada.
Semakin besar dampak keputusan sistem, semakin penting evaluasi semacam ini.
Dokumentasikan Kondisi yang Tidak Didukung
Sistem yang baik tidak harus bekerja sempurna dalam setiap kondisi.
Namun batasannya harus diketahui.
Misalnya performa belum tervalidasi pada hujan sangat deras.
Atau objek di bawah ukuran tertentu tidak dapat dideteksi secara konsisten.
Informasi seperti ini membantu pengguna memahami kapan hasil dapat dipercaya dan kapan perlu pemeriksaan tambahan.
Menyatakan keterbatasan jauh lebih baik daripada menjanjikan AI yang “selalu akurat”.
Benchmark Internal Harus Berkembang
Dataset pengujian jangan berhenti pada versi pertama.
Setiap kali menemukan failure mode penting, pertimbangkan menambahkannya ke benchmark.
Dengan begitu, model baru tidak hanya diuji terhadap masalah lama.
Ia juga harus menghadapi kesulitan yang ditemukan dari deployment nyata.
Benchmark berubah menjadi memori teknis sistem.
Jangan Upgrade Model Tanpa Membandingkan Efek Samping
Model baru mungkin meningkatkan recall.
Namun bagaimana precision-nya?
Latency?
Penggunaan GPU?
Performa malam?
Objek kecil?
Setiap versi perlu dibandingkan pada beberapa dimensi.
Peningkatan satu metrik belum tentu menghasilkan sistem yang lebih baik secara keseluruhan.
A/B Testing Bisa Digunakan dalam Kondisi yang Tepat
Untuk beberapa aplikasi, dua versi model dapat dibandingkan pada data operasional yang sama tanpa langsung mengganti sistem utama.
Hasilnya memberikan gambaran performa nyata.
Namun desain evaluasinya harus hati-hati agar perbandingan adil.
Tujuannya bukan mencari model dengan angka benchmark paling besar.
Tujuannya mencari model yang paling baik menyelesaikan pekerjaan.
Reliability Lebih Penting daripada Demo yang Spektakuler
Demo computer vision sering menggunakan kondisi ideal.
Kamera bagus.
Objek jelas.
Pencahayaan sempurna.
Hasilnya terlihat mengesankan.
Sistem produksi menghadapi hari Senin pagi yang hujan, kamera kotor, jaringan lambat, dan orang berjalan saling menutupi.
Nilai teknologi baru terlihat ketika sistem tetap memberikan hasil yang berguna dalam variasi tersebut.
Deployment Adalah Awal, Bukan Akhir Proyek AI
Dalam software tradisional, deployment sering dianggap tahap akhir sebelum maintenance.
Dalam machine learning, deployment juga merupakan awal dari pembelajaran baru.
Baru setelah model menghadapi data nyata kita mengetahui apakah asumsi selama development benar.
Monitoring.
Feedback.
Error analysis.
Data collection.
Retraining.
Semua menjadi bagian dari lifecycle.
Model dan Kamera Harus Dirancang sebagai Satu Sistem
Membeli kamera terlebih dahulu lalu mencari AI yang cocok belakangan dapat membatasi pilihan.
Begitu juga mengembangkan model tanpa mengetahui karakter kamera deployment.
Lebih baik mendesain keduanya berdasarkan kebutuhan.
Objek sekecil apa yang harus dideteksi?
Dari jarak berapa?
Pada kondisi cahaya apa?
Berapa latency yang diperlukan?
Jawaban tersebut membantu menentukan hardware dan model secara bersamaan.
Tentukan Tujuan Sebelum Mengejar Akurasi
“Bikin AI lebih akurat” terlalu luas.
Lebih baik mendefinisikan target operasional.
Misalnya sistem harus mendeteksi kendaraan tertentu dalam area tertentu dengan tingkat missed detection di bawah batas yang disepakati.
Sekarang pengembangan memiliki arah.
Kita tahu data apa yang dibutuhkan.
Metrik apa yang penting.
Dan error mana yang harus diprioritaskan.