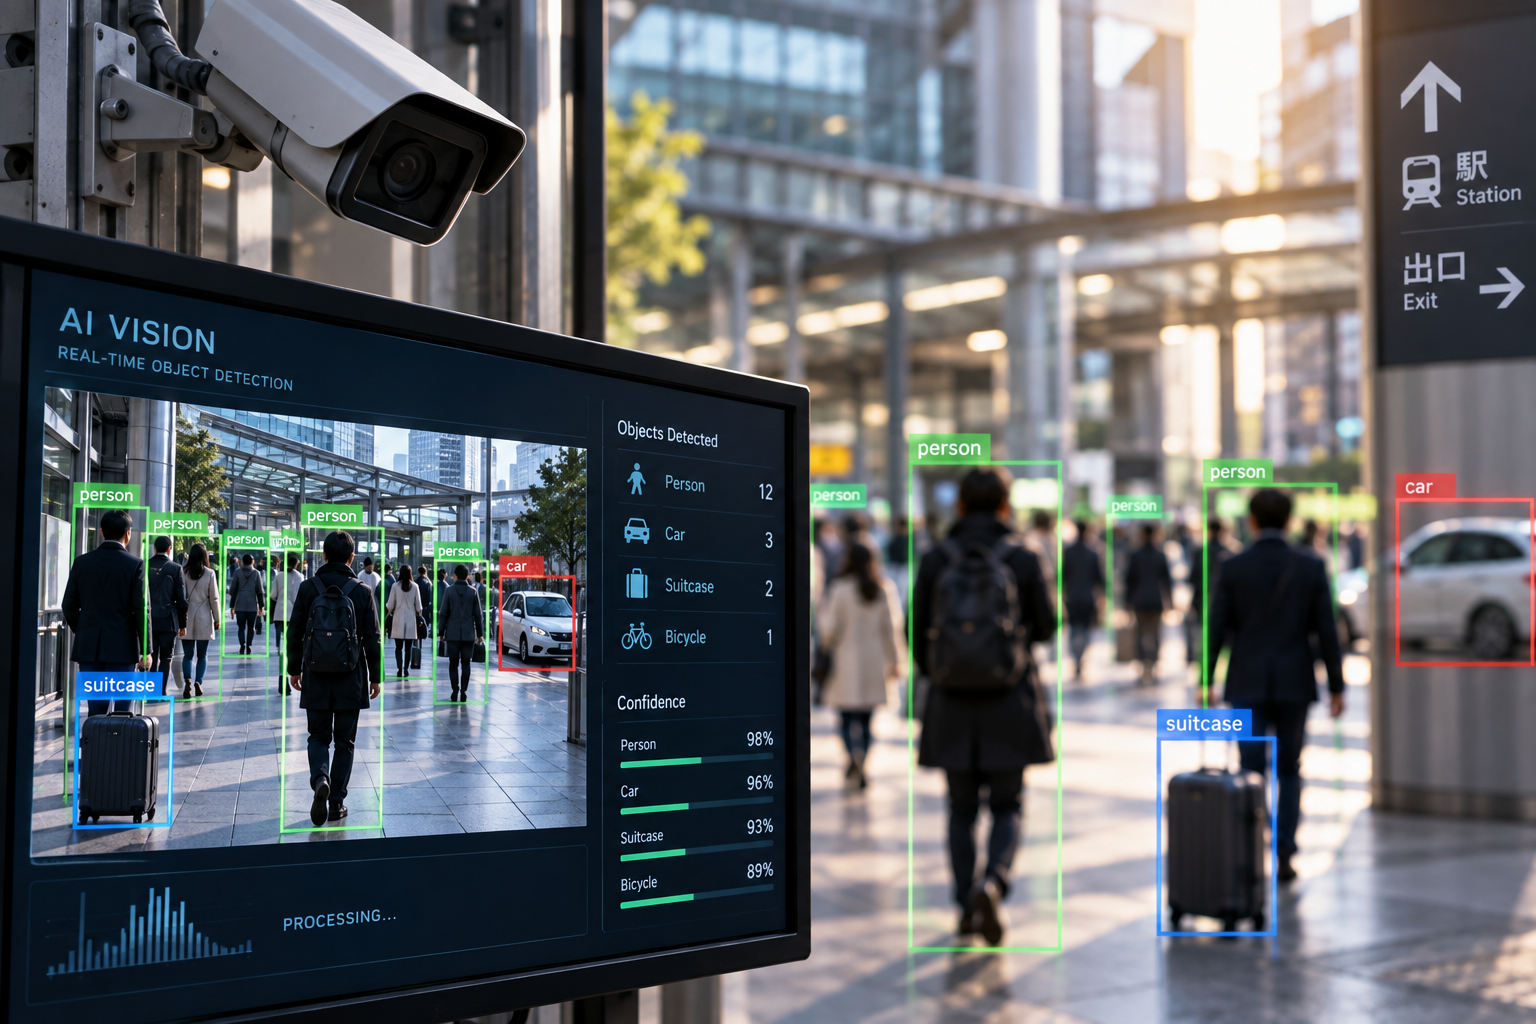
Kamera menangkap gambar dengan tajam. Objek berada tepat di tengah frame, tidak terlalu jauh, dan manusia bisa langsung mengenalinya dalam hitungan detik. Namun sistem computer vision justru memberikan label yang salah atau confidence score yang jauh lebih rendah dari biasanya.
Situasi ini sering membuat masalah terlihat seperti kegagalan kamera.
Padahal kualitas gambar hanyalah satu bagian dari sistem. Model AI tidak memahami objek dengan cara yang sama seperti manusia. Ia memproses pola visual berdasarkan data dan kondisi yang pernah digunakan selama proses pengembangan.
Karena itu, akurasi computer vision yang tinggi saat pengujian belum tentu bertahan ketika kamera dipasang di lingkungan sebenarnya.
Model Mengenali Pola, Bukan “Melihat” Seperti Manusia
Ketika manusia melihat sebuah kursi dari samping, depan, atau sedikit tertutup meja, kita biasanya tetap memahami bahwa benda tersebut adalah kursi.
Model computer vision bekerja melalui representasi visual yang dipelajari dari data.
Selama training, sistem menemukan pola yang membantu membedakan satu kategori dari kategori lain. Pola tersebut bisa berkaitan dengan bentuk, tekstur, bagian tertentu dari objek, hubungan spasial, atau berbagai karakteristik visual lainnya.
Masalah muncul ketika kondisi di lapangan berbeda jauh dari pola yang dominan dalam dataset.
Objeknya masih sama.
Representasi visual yang diterima model sudah berubah.
Dataset Training Menentukan Dunia yang Dikenal Model
Bayangkan model dilatih mengenali sebuah jenis produk menggunakan ribuan foto yang semuanya diambil di studio.
Background bersih.
Pencahayaan konsisten.
Kamera berada pada jarak hampir sama.
Produk selalu menghadap ke depan.
Model bisa mendapatkan hasil sangat baik pada data pengujian yang memiliki karakter serupa. Namun ketika dipasang di gudang, kondisinya berubah.
Kotak bertumpuk, pencahayaan tidak merata, produk terlihat dari samping, sebagian tertutup, dan kamera dipasang lebih tinggi.
Secara teknis objeknya tidak berubah. Tetapi dunia visual tempat model bekerja berubah drastis.
Inilah Kenapa Akurasi 98% Bisa Menyesatkan
Angka akurasi terdengar sangat meyakinkan.
“Model kami mencapai 98%.”
Pertanyaan berikutnya seharusnya: 98% pada data seperti apa?
Jika data pengujian berasal dari kondisi yang sangat mirip dengan training data, angka tersebut menunjukkan performa pada distribusi itu. Ia belum otomatis membuktikan performa yang sama pada seluruh kondisi operasional.
Untuk proyek nyata, metrik perlu dibaca bersama konteks dataset.
Model yang sedikit lebih rendah pada benchmark internal tetapi stabil di berbagai kondisi lapangan bisa lebih berguna daripada model dengan angka sangat tinggi pada lingkungan pengujian yang terlalu ideal.
Perubahan Cahaya Bisa Mengubah Banyak Informasi Visual
Satu objek dapat terlihat sangat berbeda pada pukul 10 pagi dan pukul 8 malam.
Bayangan berubah.
Pantulan muncul.
Sebagian warna terlihat lebih gelap.
Permukaan mengilap dapat menghasilkan highlight yang sangat terang.
Jika kamera digunakan di luar ruangan, kondisi mendung, matahari langsung, dan pencahayaan malam menciptakan variasi tambahan.
Manusia biasanya mampu mengompensasi banyak perubahan tersebut secara intuitif. Model perlu mendapatkan variasi yang relevan melalui data dan desain sistem agar dapat bekerja secara konsisten.
Kamera yang Lebih Mahal Tidak Otomatis Menyelesaikan Masalah
Meningkatkan kualitas kamera memang dapat membantu ketika sumber masalahnya adalah gambar terlalu buram, resolusi rendah, atau sensor tidak cocok dengan kondisi lingkungan.
Namun kamera bukan solusi universal.
Gambar 4K yang sangat tajam tetap bisa menghasilkan prediksi buruk jika kondisi visualnya berbeda dari data yang dipahami model.
Sebelum mengganti hardware, cari tahu penyebab error.
Apakah objek terlalu kecil?
Apakah terjadi motion blur?
Apakah pencahayaan berubah?
Atau model memang belum pernah melihat variasi tersebut selama training?
Upgrade yang tepat dimulai dari diagnosis yang tepat.
Sudut Kamera Bisa Mengubah Bentuk yang Terlihat
Sebuah objek tiga dimensi tidak memiliki satu tampilan.
Kotak dari depan terlihat seperti persegi panjang.
Dari atas, informasi yang terlihat berbeda.
Dari sudut tertentu, beberapa fitur penting bahkan bisa tersembunyi.
Jika training data terlalu didominasi satu angle, model berpotensi terlalu bergantung pada karakteristik yang hanya terlihat dari posisi tersebut.
Karena itu, dataset untuk sistem nyata perlu mempertimbangkan sudut yang memang mungkin muncul ketika sistem digunakan.
Bukan semua sudut yang bisa dibayangkan.
Yang penting adalah variasi yang relevan dengan deployment.
Background Bisa Diam-Diam Menjadi Shortcut
Ini salah satu masalah menarik dalam computer vision.
Bayangkan seluruh foto objek kategori A diambil di atas meja putih, sedangkan kategori B selalu difoto di rak hitam.
Model seharusnya mempelajari objek.
Tetapi background ternyata menjadi petunjuk yang sangat konsisten.
Sistem bisa menggunakan korelasi tersebut sebagai shortcut.
Ketika objek A suatu hari ditempatkan di rak hitam, prediksi menjadi kacau.
Karena itu, variasi background penting untuk mengurangi kemungkinan model mempelajari hubungan yang tidak benar-benar mewakili objek.
Objek yang Tertutup Sebagian Lebih Sulit
Dalam demo, objek biasanya terlihat sempurna.
Di dunia nyata, objek saling menutupi.
Orang berjalan di depan kamera. Kardus berada di belakang pallet. Produk bertumpuk. Kendaraan tertutup kendaraan lain.
Kondisi ini disebut occlusion.
Semakin sedikit bagian objek yang terlihat, semakin sedikit informasi visual yang tersedia untuk sistem.
Dataset yang hanya berisi objek utuh dapat membuat performa terlihat bagus sampai sistem menghadapi lingkungan yang penuh overlap.
Ukuran Objek di Frame Juga Penting
Model mungkin sangat baik mengenali objek ketika objek tersebut memenuhi sebagian besar gambar.
Lalu kamera dipasang jauh lebih tinggi.
Sekarang objek yang sama hanya menggunakan sebagian kecil frame.
Detail yang sebelumnya mudah terlihat menjadi sangat kecil.
Ini sangat relevan untuk penggunaan seperti CCTV, monitoring area luas, inspeksi dari jarak tertentu, atau analisis objek kecil.
Resolusi kamera penting, tetapi desain penempatan kamera sama pentingnya.
Kamera perlu dipasang berdasarkan informasi visual yang dibutuhkan sistem.
Motion Blur Bisa Menghapus Detail Penting
Objek diam relatif mudah difoto.
Objek bergerak adalah cerita berbeda.
Conveyor bergerak cepat, kendaraan melintas, tangan operator berpindah, atau kamera sendiri mengalami getaran.
Jika exposure dan kondisi pencahayaan tidak mendukung, detail objek dapat berubah menjadi blur.
Bagi manusia, konteks mungkin masih cukup untuk menebak objek tersebut.
Model tidak selalu memiliki keuntungan yang sama.
Untuk sistem real-time, pengujian harus memasukkan kondisi gerak yang benar-benar akan terjadi.
Confidence Tinggi Tidak Selalu Berarti Prediksi Benar
Model dapat memberikan confidence score tinggi dan tetap salah.
Confidence menunjukkan keyakinan model berdasarkan mekanisme prediksinya, bukan jaminan bahwa realitas sesuai dengan label tersebut.
Ini penting ketika sistem digunakan untuk membuat keputusan otomatis.
Jangan menganggap angka 0,97 berarti sistem “97% pasti benar” dalam setiap konteks.
Threshold sebaiknya ditentukan melalui evaluasi pada data yang representatif terhadap penggunaan nyata.
Untuk kasus tertentu, prediksi dengan confidence rendah juga bisa diarahkan ke pemeriksaan manual daripada dipaksa menjadi keputusan otomatis.
False Positive dan False Negative Tidak Selalu Sama Dampaknya
Bayangkan sistem inspeksi kualitas.
False positive mungkin membuat produk yang sebenarnya baik dianggap bermasalah.
False negative membuat produk cacat lolos.
Keduanya merupakan error, tetapi dampak bisnisnya bisa berbeda.
Pada aplikasi lain, prioritasnya dapat terbalik.
Karena itu, mengejar satu angka akurasi computer vision saja sering tidak cukup.
Evaluasi perlu mempertimbangkan jenis kesalahan yang paling penting untuk kasus penggunaan tersebut.
Precision, recall, confusion matrix, dan metrik lain dapat memberikan gambaran yang lebih berguna tergantung tugasnya.
Data Validation Harus Menyerupai Dunia Nyata
Dataset sebaiknya dipisahkan dengan hati-hati antara training, validation, dan testing.
Namun pemisahan file saja belum cukup.
Jika foto yang hampir identik dari sesi kamera yang sama tersebar di training dan testing, hasil pengujian bisa terlihat terlalu bagus.
Model sebenarnya sedang diuji pada kondisi yang sudah sangat familiar.
Untuk deployment nyata, test set sebaiknya memasukkan variasi yang memang ingin dihadapi sistem: lokasi berbeda, waktu berbeda, objek berbeda, pencahayaan berbeda, atau kondisi lain yang relevan.
Pengujian harus menantang asumsi model, bukan sekadar mengonfirmasi bahwa training berhasil.
Data Augmentation Membantu, tetapi Bukan Pengganti Data Nyata
Developer dapat menggunakan data augmentation untuk membuat variasi gambar selama training.
Gambar dapat dipotong, dibalik dalam kasus yang sesuai, diubah brightness-nya, atau diberikan transformasi tertentu.
Teknik ini membantu model menghadapi variasi.
Namun augmentation harus masuk akal terhadap dunia tempat sistem digunakan.
Membuat ratusan transformasi sintetis tidak otomatis menggantikan data lapangan.
Jika deployment memiliki kondisi unik, contoh nyata dari kondisi tersebut tetap sangat berharga.
Error Harus Dikumpulkan, Bukan Dihapus dari Demo
Ketika model salah mengenali objek, contoh tersebut justru merupakan data penting.
Simpan kasus error.
Kelompokkan berdasarkan penyebab.
Apakah sering gagal ketika gelap?
Ketika objek kecil?
Ketika dua objek bertumpuk?
Ketika kamera tertentu digunakan?
Dari sini tim dapat menemukan pola kegagalan.
Seratus error yang dikelompokkan dengan baik sering memberi informasi lebih berguna daripada sekadar melihat satu angka accuracy di dashboard.
Jangan Retrain Model Secara Membabi Buta
Begitu error ditemukan, respons pertama sering kali adalah memasukkan lebih banyak data lalu training ulang.
Belum tentu itu solusi terbaik.
Masalah bisa berasal dari kamera yang salah posisi, label data yang tidak konsisten, preprocessing berbeda antara training dan production, atau threshold yang tidak sesuai.
Cari root cause terlebih dahulu.
Jika memang kekurangan variasi data, barulah dataset diperbaiki.
Computer vision adalah sistem lengkap. Model hanyalah salah satu komponennya.
Konsistensi Label Sangat Menentukan
Dataset besar belum tentu dataset bagus.
Bayangkan lima annotator memiliki interpretasi berbeda tentang kapan sebuah objek dianggap “rusak”.
Satu orang memberi label cacat.
Orang lain menganggapnya normal.
Model sekarang menerima target yang tidak konsisten.
Sebelum menambah ribuan gambar, pastikan definisi kelas jelas.
Panduan labeling yang baik dapat memberikan peningkatan kualitas yang lebih berarti daripada sekadar memperbesar jumlah data.
Uji Sistem di Lokasi Deployment Sebelum Mengandalkannya
Lab memberikan lingkungan yang terkontrol.
Deployment memberikan kenyataan.
Sebelum sistem digunakan sebagai bagian penting dari workflow, lakukan pengujian pada kamera, lokasi, pencahayaan, jarak, dan aktivitas yang sebenarnya.
Biarkan sistem menghadapi kondisi buruk juga.
Pagi.
Malam.
Area ramai.
Objek tertutup.
Kamera sedikit kotor jika kondisi tersebut realistis.
Tujuannya bukan membuat model terlihat bagus.
Tujuannya menemukan kegagalan sebelum kegagalan tersebut menjadi masalah operasional.
Monitoring Tidak Berakhir Setelah Sistem Diluncurkan
Lingkungan bisa berubah.
Lampu diganti.
Layout gudang dipindahkan.
Produk mendapatkan kemasan baru.
Kamera bergeser.
Musim mengubah intensitas cahaya.
Perubahan kecil ini dapat menyebabkan data produksi perlahan berbeda dari kondisi awal.
Karena itu, performa computer vision perlu dipantau setelah deployment, terutama ketika sistem digunakan dalam jangka panjang.
Model yang bekerja baik hari ini tidak mendapatkan jaminan bahwa lingkungannya akan tetap sama selamanya.
Bangun Feedback Loop dari Dunia Nyata
Sistem yang matang dapat menggunakan hasil operasional sebagai sumber pembelajaran.
Kasus dengan confidence rendah dapat ditinjau.
Prediksi yang dikoreksi manusia dapat dikumpulkan.
Jenis error baru dapat dimasukkan ke evaluasi berikutnya.
Dengan begitu, dataset berkembang berdasarkan masalah yang benar-benar terjadi.
Bukan berdasarkan tebakan tentang semua situasi yang mungkin terjadi.
Ini membuat pengembangan model menjadi siklus:
deploy → observe → collect errors → improve data → evaluate → deploy again.
Akurasi yang Berguna Adalah Akurasi di Kondisi Nyata
Demo yang sempurna memang menarik.
Namun nilai computer vision baru terlihat ketika sistem menghadapi variasi dunia sebenarnya.
Model harus bertemu dengan cahaya yang berubah, objek yang tidak selalu menghadap kamera, background yang berantakan, pergerakan, occlusion, dan kondisi yang tidak pernah terlihat sebersih dataset contoh.
Karena itu, target terbaik bukan membuat model terlihat sempurna dalam satu video demo.
Targetnya adalah mengetahui secara jelas kapan sistem bekerja, kapan performanya menurun, dan bagaimana workflow menangani ketidakpastian tersebut.
Kesimpulan
Akurasi computer vision tidak hanya ditentukan oleh seberapa canggih model AI atau seberapa tajam kameranya. Kualitas dan variasi dataset, sudut kamera, pencahayaan, background, ukuran objek, occlusion, motion blur, konsistensi labeling, serta kondisi deployment semuanya ikut menentukan hasil.
Itulah sebabnya model yang mencapai angka sangat tinggi selama development bisa memberikan performa berbeda ketika dipindahkan ke dunia nyata.
Jangan hanya bertanya, “Berapa accuracy model ini?”
Tanyakan juga, “Dalam kondisi apa angka tersebut diukur, dan apakah kondisi itu benar-benar mewakili tempat sistem akan digunakan?”
Computer vision yang matang bukan sistem yang tidak pernah salah.
Ia adalah sistem yang kegagalannya dipahami, diuji, dipantau, dan terus digunakan untuk membuat versi berikutnya lebih sesuai dengan dunia yang benar-benar dilihat kameranya.