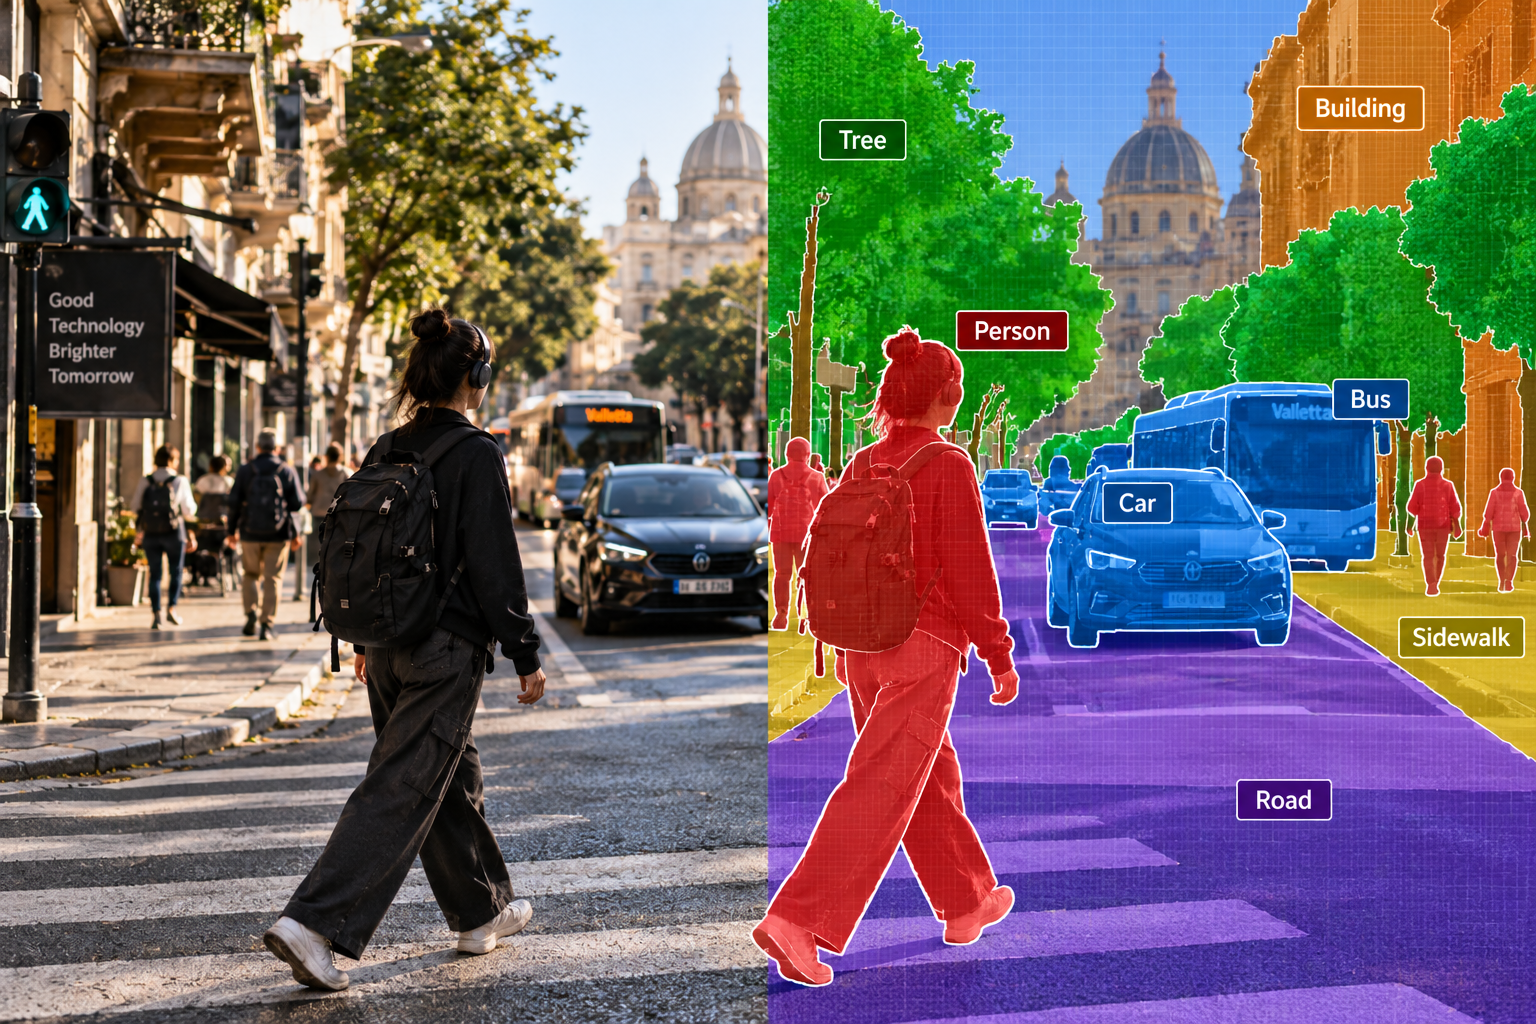
Sebuah mobil dengan kamera berhenti di persimpangan. Dalam satu gambar yang sama terdapat jalan, trotoar, kendaraan, pejalan kaki, pohon, tiang, dan bangunan yang saling berdekatan.
Bagi manusia, batas setiap objek terlihat cukup jelas.
Komputer menerima sesuatu yang jauh lebih sederhana: kumpulan piksel dengan nilai warna dan intensitas tertentu. Tidak ada informasi bawaan yang mengatakan bahwa kumpulan piksel di sebelah kiri adalah trotoar atau bentuk di depan kendaraan adalah seorang pejalan kaki.
Salah satu teknologi yang digunakan untuk memahami gambar sedetail itu adalah image segmentation. Memahami cara kerja image segmentation membantu menjelaskan bagaimana sistem computer vision dapat menganalisis bukan hanya objek apa yang terdapat dalam gambar, tetapi juga bagian mana dari gambar yang benar-benar menjadi milik objek tersebut.
Object Detection dan Image Segmentation Tidak Sama
Pada object detection, sistem biasanya mencari objek lalu menandai lokasinya menggunakan bounding box.
Misalnya kamera melihat tiga mobil. Model dapat menghasilkan tiga kotak yang menunjukkan posisi setiap mobil dalam frame.
Pendekatan tersebut sudah sangat berguna, tetapi kotak tidak mengikuti bentuk objek secara presisi. Sebagian area di dalam bounding box sebenarnya bisa berisi jalan, kendaraan lain, atau background.
Image segmentation mencoba memberikan informasi yang lebih detail dengan menentukan kategori pada tingkat piksel.
Alih-alih hanya mengetahui “ada mobil di area ini”, sistem dapat mencoba menentukan piksel mana yang termasuk mobil dan mana yang termasuk lingkungan di sekitarnya.
Bayangkan Gambar Sebagai Jutaan Potongan Kecil
Sebuah gambar digital tersusun dari piksel.
Jika resolusinya 1920 × 1080, terdapat lebih dari dua juta piksel dalam satu frame. Setiap piksel membawa informasi visual, tetapi satu piksel sendirian biasanya belum cukup untuk memahami sebuah objek.
Model computer vision perlu mempelajari pola dari banyak piksel sekaligus.
Tekstur, warna, tepi, bentuk, serta konteks di sekitarnya membantu model membangun representasi visual.
Dari representasi tersebut, sistem dapat memperkirakan kategori untuk berbagai bagian gambar.
Hasil akhirnya sering divisualisasikan sebagai segmentation mask.
Apa Itu Segmentation Mask?
Segmentation mask merupakan representasi area gambar yang telah diklasifikasikan.
Bayangkan sebuah foto jalan kota. Sistem dapat menghasilkan mask yang membedakan area jalan, kendaraan, manusia, bangunan, dan langit.
Visualisasi biasanya menggunakan warna berbeda agar manusia mudah membacanya.
Namun warna tersebut bukan berarti AI benar-benar “melihat” jalan sebagai warna tertentu.
Warna hanya cara visual untuk menunjukkan hasil klasifikasi.
Informasi pentingnya adalah hubungan antara posisi piksel dan kategori yang diprediksi model.
Semantic Segmentation Mengelompokkan Piksel Berdasarkan Kategori
Salah satu jenis utama teknologi ini adalah semantic segmentation.
Tujuannya adalah memberikan kelas semantik kepada piksel.
Semua piksel yang dianggap sebagai jalan dapat masuk kelas “road”. Semua bagian kendaraan masuk kelas “vehicle”. Langit menjadi “sky”, dan seterusnya.
Masalahnya, semantic segmentation tidak selalu membedakan dua objek dari kategori yang sama sebagai individu terpisah.
Jika ada tiga orang berdiri berdekatan, ketiganya dapat dianggap sebagai satu kelompok kategori “person”.
Dalam beberapa aplikasi, informasi tersebut sudah cukup.
Dalam aplikasi lain, kita perlu mengetahui individu mana yang merupakan orang pertama, kedua, dan ketiga.
Instance Segmentation Memisahkan Objek Satu per Satu
Di sinilah instance segmentation menjadi relevan.
Teknologi ini tidak hanya mencoba mengetahui kategori objek, tetapi juga membedakan setiap instance.
Misalnya terdapat empat mobil.
Semantic segmentation dapat mengatakan seluruh area tersebut merupakan kategori mobil.
Instance segmentation mencoba menghasilkan mask terpisah untuk mobil A, B, C, dan D.
Kemampuan ini berguna ketika sistem perlu menghitung objek, menganalisis bentuk masing-masing objek, atau mengikuti individu tertentu dalam sebuah scene.
Kenapa Tidak Cukup Menggunakan Bounding Box?
Bounding box jauh lebih sederhana dan untuk banyak aplikasi sudah mencukupi.
Jika sistem hanya perlu mengetahui bahwa ada kendaraan di depan, koordinat kotak mungkin sudah memberikan informasi yang dibutuhkan.
Tetapi beberapa pekerjaan membutuhkan bentuk yang lebih presisi.
Bayangkan robot harus mengambil sebuah benda dari tumpukan.
Mengetahui lokasi umum benda belum tentu cukup jika benda tersebut bersentuhan atau tumpang tindih dengan objek lain.
Mask yang mengikuti bentuk objek dapat membantu sistem memahami area target secara lebih detail.
Jadi image segmentation bukan otomatis pengganti object detection. Keduanya digunakan sesuai kebutuhan.
Bagaimana AI Belajar Melakukan Segmentasi?
Model membutuhkan data pelatihan.
Dalam supervised learning, gambar dapat disertai anotasi yang menunjukkan bagian mana termasuk kategori tertentu.
Untuk segmentation, anotasinya lebih detail dibanding label gambar sederhana.
Jika dataset berisi foto jalan, anotator mungkin harus menandai area kendaraan, manusia, jalan, trotoar, dan kategori lain yang dibutuhkan.
Model kemudian membandingkan prediksinya dengan ground truth tersebut.
Kesalahan digunakan untuk memperbarui parameter model selama proses training.
Setelah melihat banyak contoh, model belajar pola visual yang membantu melakukan prediksi pada gambar baru.
Membuat Data Segmentation Bisa Mahal
Menulis label “cat” pada sebuah foto relatif cepat.
Menggambar batas presisi mengelilingi tubuh kucing jauh lebih memakan waktu.
Sekarang bayangkan hal tersebut dilakukan terhadap ribuan atau jutaan objek.
Inilah salah satu tantangan besar dalam membangun dataset segmentation.
Semakin detail anotasi yang dibutuhkan, semakin besar pula usaha yang diperlukan untuk menghasilkan data berkualitas.
Karena itu, pengembangan modern juga memanfaatkan berbagai pendekatan seperti pre-trained models, semi-supervised learning, synthetic data, dan teknik lain untuk mengurangi ketergantungan pada anotasi manual dalam setiap kasus.
Tepi Objek Adalah Bagian yang Sulit
Benda di dunia nyata jarang memiliki batas sempurna.
Rambut manusia memiliki banyak helai tipis.
Daun pohon saling bertumpuk.
Objek transparan memperlihatkan background.
Bayangan dapat menyerupai bagian benda.
Motion blur membuat tepi tidak tajam.
Karena itu, menentukan batas objek pada tingkat piksel dapat jauh lebih sulit dibanding sekadar menemukan lokasi umumnya.
Semakin rumit scene, semakin besar tantangan segmentasinya.
Objek yang Bertumpuk Membuat Masalah Lebih Sulit
Bayangkan lima orang berdiri berdekatan.
Sebagian tubuh orang pertama tertutup orang kedua. Tas menutupi bagian pakaian. Tangan seseorang berada di depan tubuh orang lain.
Manusia dapat menggunakan konteks untuk memahami struktur scene tersebut.
Model juga harus belajar menangani occlusion atau kondisi ketika sebagian objek tertutup.
Jika informasi visual terlalu sedikit, prediksi dapat menjadi tidak pasti.
Hal ini menunjukkan bahwa segmentasi bukan sekadar mencari perbedaan warna antarpiksel.
Sistem harus memahami pola visual yang lebih kompleks.
Pencahayaan Bisa Mengubah Tampilan Objek
Mobil yang sama dapat terlihat berbeda saat pagi, siang, malam, atau ketika berada di bawah bayangan.
Permukaannya juga bisa memantulkan lingkungan.
Kamera yang berbeda menghasilkan karakter gambar berbeda.
Karena itu, model yang hanya dilatih pada kondisi sangat terbatas berisiko kesulitan ketika menghadapi dunia nyata.
Dataset yang baik perlu merepresentasikan variasi yang relevan dengan lingkungan penggunaan.
Tujuannya bukan hanya membuat model akurat pada gambar training, tetapi mampu melakukan generalisasi terhadap kondisi baru.
Image Segmentation pada Kendaraan
Salah satu contoh yang mudah dibayangkan adalah sistem persepsi kendaraan.
Kamera dapat menangkap jalan beserta lingkungan di sekitarnya.
Segmentation dapat membantu mengidentifikasi area yang berhubungan dengan jalan, marka, kendaraan, pejalan kaki, atau elemen lingkungan lain, tergantung desain sistem.
Informasi visual tersebut kemudian dapat digunakan bersama sensor dan komponen lain.
Yang penting dipahami, satu model segmentation bukan berarti kendaraan otomatis “mengerti semuanya”.
Sistem nyata biasanya menggabungkan banyak proses persepsi, prediksi, sensor, dan kontrol.
Robot Industri Juga Membutuhkan Pemahaman Bentuk
Dalam manufaktur, objek tidak selalu tersusun rapi.
Komponen dapat berada dalam wadah, bertumpuk, atau memiliki orientasi berbeda.
Robot yang perlu mengambil benda tertentu membutuhkan informasi tentang lokasi dan bentuk target.
Segmentation dapat menjadi salah satu bagian dari sistem vision yang membantu memisahkan target dari background atau benda lain.
Informasi tersebut kemudian dapat digunakan untuk proses berikutnya, misalnya menentukan titik pengambilan.
Di sinilah computer vision mulai terhubung langsung dengan tindakan fisik.
Teknologi yang Sama Bisa Membantu Editing Foto
Image segmentation tidak hanya digunakan dalam sistem industri.
Banyak fitur editing modern membutuhkan kemampuan memisahkan subjek dari background.
Ketika aplikasi dapat memilih seseorang tanpa pengguna menggambar garis secara manual mengelilingi tubuhnya, ada proses visual yang mencoba menentukan area subjek.
Background kemudian bisa dibuat blur, diganti, atau diedit secara terpisah.
Implementasi setiap aplikasi tentu berbeda.
Namun masalah dasarnya mirip: sistem perlu mengetahui piksel mana yang termasuk subjek dan mana yang bukan.
Video Membuat Tantangannya Bertambah
Melakukan segmentasi pada satu gambar sudah cukup kompleks.
Video menambahkan dimensi waktu.
Jika sebuah objek terdeteksi pada frame pertama, hasil pada frame berikutnya idealnya tetap konsisten saat objek bergerak, berubah posisi, atau tertutup sesaat.
Jika mask terus berubah secara tidak stabil, hasil visual maupun analisis dapat terganggu.
Karena itu, video segmentation dapat memanfaatkan informasi temporal selain informasi dari satu frame.
Konsep ini juga dapat berhubungan dengan object tracking, tetapi keduanya bukan teknologi yang sama.
Tracking fokus mempertahankan identitas objek sepanjang waktu, sementara segmentation fokus pada area objek secara detail.
Akurasi Saja Tidak Selalu Cukup
Bayangkan sistem mendapatkan akurasi piksel sangat tinggi karena sebagian besar gambar merupakan background.
Angka tersebut terlihat bagus.
Tetapi jika sistem terus gagal mengenali objek kecil yang sebenarnya paling penting, performanya belum tentu berguna.
Karena itu, evaluasi segmentation menggunakan metrik yang lebih sesuai dengan tugasnya.
Salah satu konsep yang sering ditemui adalah Intersection over Union (IoU), yang membandingkan area prediksi dengan area ground truth.
Metrik seperti ini membantu menilai seberapa baik mask prediksi benar-benar bertumpang tindih dengan target yang benar.
Kecepatan Juga Menjadi Pertimbangan
Model yang sangat detail bisa membutuhkan komputasi besar.
Untuk analisis gambar offline, waktu pemrosesan mungkin tidak terlalu kritis.
Namun aplikasi real-time memiliki kebutuhan berbeda.
Robot, kamera pintar, atau sistem interaktif mungkin harus memproses frame dengan cepat.
Pengembang akhirnya perlu menyeimbangkan beberapa hal: akurasi, resolusi, ukuran model, penggunaan memori, konsumsi daya, dan latency.
Model terbaik di benchmark belum tentu menjadi model terbaik untuk perangkat tertentu.
Edge AI Membawa Segmentasi Lebih Dekat ke Kamera
Tidak semua gambar harus dikirim ke server cloud untuk dianalisis.
Dengan perkembangan hardware dan model yang lebih efisien, sebagian pemrosesan computer vision dapat dilakukan langsung pada perangkat atau edge device.
Pendekatan ini dapat membantu mengurangi latency dan kebutuhan mengirim data mentah secara terus-menerus, tergantung desain sistem.
Namun perangkat edge memiliki keterbatasan komputasi dan energi.
Karena itu, optimasi model menjadi penting.
Model harus cukup pintar untuk menjalankan tugasnya, tetapi juga cukup efisien untuk hardware yang digunakan.
Segmentation Bukan Berarti AI Memahami Dunia Seperti Manusia
Ketika melihat visualisasi segmentation yang rapi, mudah menganggap AI sudah memahami sebuah scene seperti manusia.
Padahal output model merupakan prediksi berdasarkan pola yang dipelajari dari data.
Sistem bisa salah.
Objek baru, kondisi pencahayaan tidak biasa, kamera buruk, occlusion, atau data yang berbeda dari training distribution dapat menurunkan performa.
Karena itu, aplikasi penting membutuhkan pengujian terhadap kondisi penggunaan sebenarnya.
Visualisasi yang terlihat mengesankan bukan pengganti evaluasi sistem.
Dari Piksel Menjadi Informasi yang Bisa Digunakan
Inilah bagian menarik dari cara kerja image segmentation.
Pada awal proses, kamera hanya menghasilkan gambar.
Setelah diproses, sistem dapat memiliki representasi yang jauh lebih terstruktur tentang area di dalam gambar.
Piksel tertentu diperkirakan sebagai jalan.
Piksel lain menjadi manusia.
Bagian lainnya menjadi kendaraan atau background.
Informasi ini kemudian dapat digunakan oleh komponen berikutnya untuk membuat analisis atau menjalankan fungsi tertentu.
Dengan kata lain, segmentation membantu mengubah gambar mentah menjadi representasi visual yang lebih mudah digunakan mesin.
Kesimpulan
Memahami cara kerja image segmentation berarti memahami bagaimana computer vision dapat bergerak dari sekadar mengetahui keberadaan objek menuju pemahaman lokasi objek pada tingkat yang jauh lebih detail.
Object detection biasanya memberikan lokasi umum menggunakan bounding box. Semantic segmentation mengklasifikasikan area gambar berdasarkan kategori, sementara instance segmentation dapat memisahkan beberapa objek dari kelas yang sama menjadi individu berbeda.
Kemampuan tersebut membuat segmentation berguna dalam banyak aplikasi, mulai dari robot industri dan sistem kendaraan hingga pemrosesan video dan editing foto.
Namun hasilnya tetap bergantung pada data, model, kondisi visual, kebutuhan komputasi, serta cara sistem diuji.
Bagi manusia, batas antara seseorang dan background terlihat begitu alami sehingga kita hampir tidak pernah memikirkannya.
Bagi komputer, menemukan batas tersebut adalah masalah yang membutuhkan jutaan piksel, data pelatihan, dan model computer vision untuk menyelesaikannya.